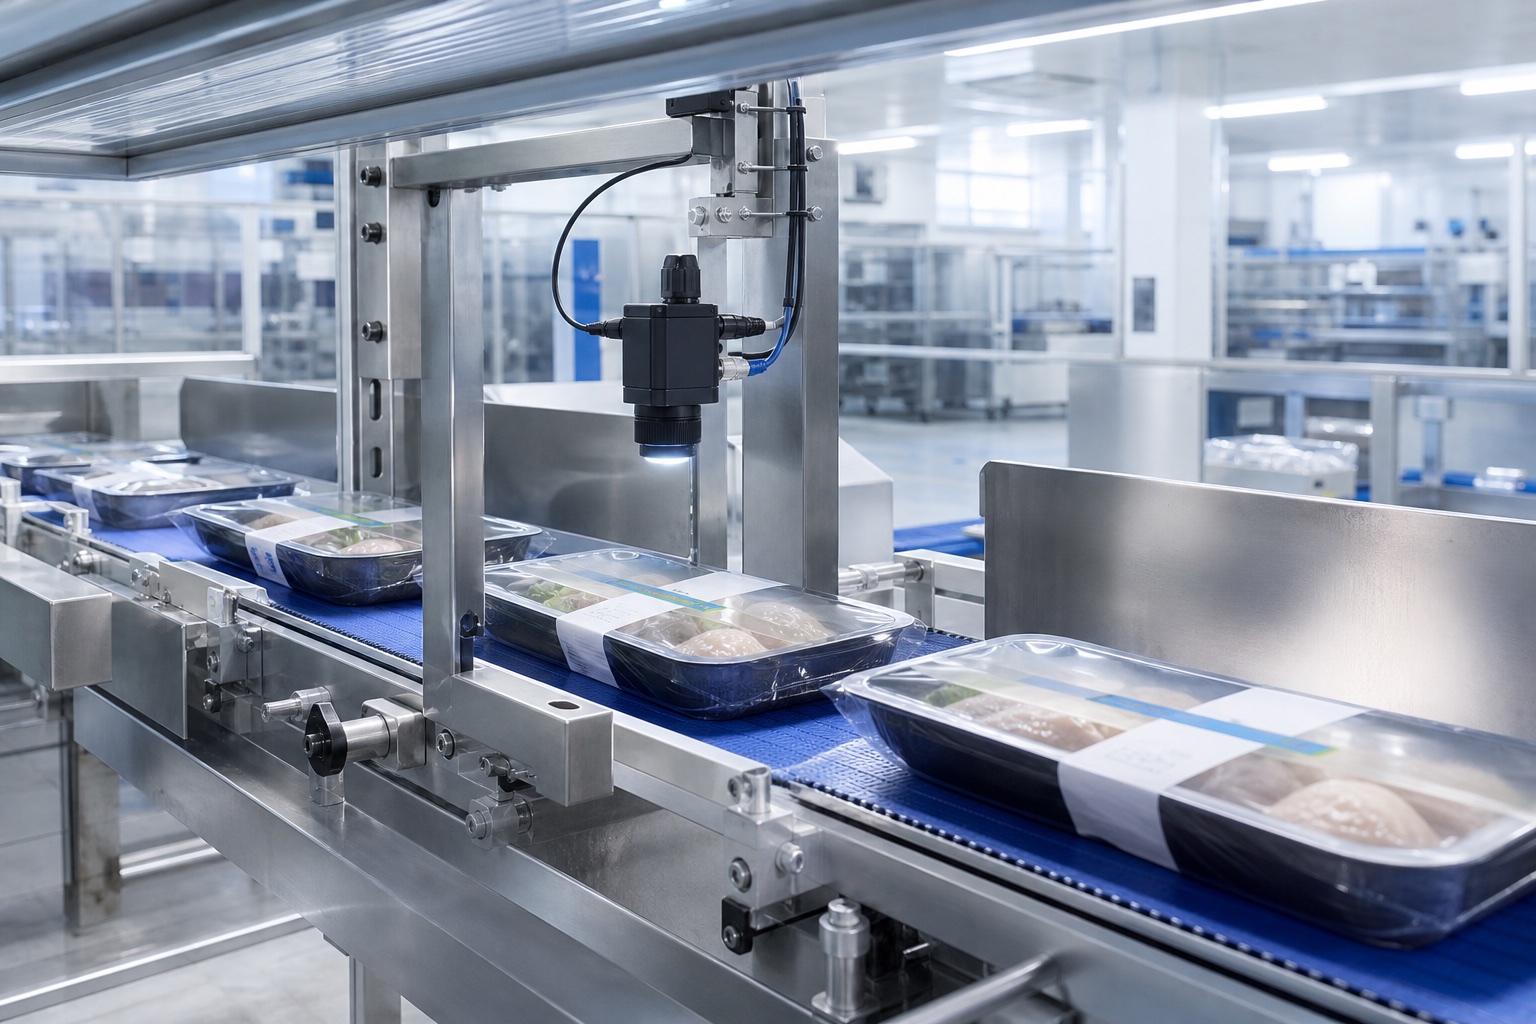
技术解读 · 公开资料解读,配图为场景示意。
本文要点
视觉案例应分别说明缺陷样本量、漏检、合格品误判和运行节拍。准确率必须连同测试集与判定口径阅读,不能单独代表质量风险。
背景与依据
NIST AI RMF 1.0 第 3.1 节提到误报、漏报等测量维度。本文进一步以质量检测为例说明分项统计的重要性;以下数字仅为计算示例。 [1]
总准确率为何可能掩盖漏检
假设测试集中有 990 件合格品和 10 件缺陷品,系统把所有产品都判为合格,总准确率仍是 99%,但 10 件缺陷全部漏掉。这个假设说明样本结构会影响数字含义。
因此,阅读案例时建议先找出各类缺陷的数量和识别结果,尤其关注严重缺陷是否有足够测试证据。
漏检与误检要用不同分母
在本文口径下,漏检率为漏判合格的缺陷品数除以实际缺陷品数;误检率为被判异常的合格品数除以实际合格品数。报告应说明自己的口径是否相同。
测试集中没有某类缺陷时,不能把该类漏检率写成零。应说明没有覆盖,并补充测试计划。
模型通过,还要看工位是否跟得上
现场还包括拍照、传输、剔除与复检。算法速度达标,并不保证整站能在实际线速下完成任务。
建议同时查看连续运行的超时、漏拍、剔除失败和人工复核耗时。只有把这些记录放在一起,才能理解案例展示的检测能力。
避免用一个总数替代质量判断
澄序工业建议把缺陷类型、统计分母和人工复核量放在同一份报告中。数据量不足时明确写出限制,让采购与质量人员能判断适用范围。
阅读要点对照
| 关注点 | 应该看什么 | 容易忽略什么 |
|---|---|---|
| 漏检率 | 漏检缺陷品 / 实际缺陷品 | 样本缺失被写成零 |
| 误检率 | 误判合格品 / 实际合格品 | 分母被混用 |
| 整站表现 | 漏拍、超时、剔除与复检 | 只报告模型指标 |
延伸一问
同样 99% 的准确率,可以直接比较两套系统吗?
不能。需要核对缺陷比例、类别、严重程度、测试集独立性和工况,再比较分项结果。
参考资料与阅读范围
- AI RMF 1.0:AI Risks and Trustworthiness,第 3.1 节 ↗
美国国家标准与技术研究院(NIST) · 2023 年版 · 查阅日期:2026-09-10
本文为公开资料解读与方案建议;文中场景和计算示例不代表企业历史业绩。技术要求需结合设备资料与现场条件核验。 来源用于支持上文标明的背景;正文的场景分析与建议不代表来源机构的项目结论或对本站的认可。